Настройка пагинации на сайте для SEO
Под словом «пагинация» обычно лежат сразу несколько разных задач: как подгружается контент, какие при этом появляются адреса и что из этого должно попадать в поиск. Разбираю их по отдельности.
 Алексей АнисинSEO-специалист, Москва

Почему к пагинации приходится возвращаться
Если бы вопросы с SEO-собеседований складывали в отдельный рейтинг, пагинация и сегодня держалась бы где-то рядом с canonical, robots.txt и переездами сайта. Тема старая, рекомендации поисковых систем существуют не первый год. Казалось бы, что там еще обсуждать?
Проблема в том, что под словом «пагинация» часто смешивают сразу несколько разных моментов:
- Как человек загружает следующую порцию контента.
- Есть ли у этой порции отдельный URL.
- Может ли поисковый робот найти URL и перейти по нему.
- Нужно ли конкретной странице быть доступной для индексирования.
Стоит объединить эти вопросы в один, и получается знакомый спор: «индексировать всю пагинацию или закрыть?» Оба ответа могут оказаться неправильными, если не уточнить, о каком сайте и каком классе URL идет речь.
Моя статья 2021 года для SEOnews была в основном написана вокруг интернет-магазинов и исходила из более простой развилки. За прошедшее время официальная позиция Google стала яснее, я стал умнее и понял что тема нуждается в сильной акутализации и детализации. Пагинация живет не только в товарных категориях, она нужна:
- новостям,
- блогам,
- форумам,
- доскам объявлений,
- каталогам врачей и специалистов,
- базам знаний,
- разделам отзывов,
- вакансиям
- и практически любому сайту с длинным списком элементов.
О чем вообще речь?
Пагинация делит длинный список на части. Пользователю не приходится загружать все сразу, а сайт получает управляемые порции контента.
В интерфейсе это обычно выглядит одним из трех способов.
Нумерация
У каждой части есть номер, а пользователь переходит между страницами по ссылкам:
example.ru/catalog/holodilniki/page/2/example.ru/catalog/holodilniki/?page=2
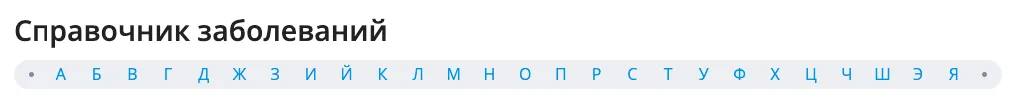
Сюда же можно отнести разбиение по буквам, диапазонам дат и другим понятным сегментам. Формально это не всегда страницы 1, 2, 3, но задача та же: разделить большой набор и дать каждой части адрес.
Кнопка «Показать ещё»
Следующая порция появляется после клика. При этом возможны два совершенно разных технических варианта:
- браузер загружает данные, но адрес и история переходов не меняются;
- интерфейс подгружает элементы, одновременно связывая состояние с URL второй, третьей и следующих страниц.
На экране эти варианты выглядят одинаково. Для поискового робота и кнопки «Назад» в браузере разница принципиальная.
Бесконечная лента
Это автоматизированный вариант той же подгрузки: пользователь доходит до конца видимого списка, и сайт добавляет следующую порцию. Удобство зависит от контекста. Для ленты публикаций такой паттерн может быть естественным, а в каталоге, где нужно сравнить позиции и вернуться к определенному месту, способен раздражать.
Удобная модель выглядит так:
Именно эту цепочку нужно проектировать.
Где пагинация нужна, кроме интернет-магазинов
У разных сайтов одна техническая конструкция обслуживает разные по смыслу списки. Поэтому копировать схему крупного магазина в новостной архив или каталог юристов без проверки не стоит.
| Тип сайта | Что делится на страницы | Главный риск | Что проверить в первую очередь |
|---|---|---|---|
| Интернет-магазин или маркетплейс | Товары в категории, предложения продавцов | Глубокие карточки плохо обнаруживаются; фильтры и сортировки создают лишние URL | Ссылки на карточки, стабильность сортировки, отдельная политика для фасетов |
| Каталог услуг и специалистов | Врачи, юристы, мастера, клиники, компании | Состав списка меняется, а близкие фильтры выглядят одинаково | Ценность каждого среза, география, доступ к профилям |
| Доска объявлений | Объявления, автомобили, недвижимость, вакансии | Объекты быстро появляются и исчезают, границы страниц постоянно сдвигаются | Срок жизни карточек, обработка удаленных объектов, предсказуемая сортировка |
| Блог или медиа | Статьи, новости, материалы тега или автора | Новые публикации сдвигают старые на более глубокие страницы | Доступность архива, ссылки на старые материалы, работа дат и рубрик |
| Форум | Темы, сообщения внутри темы, ответы пользователя | Контент растет с двух сторон: появляются новые темы и новые сообщения | Постоянные ссылки на сообщения, переход к нужной странице обсуждения |
| Отзывы и комментарии | Отзывы о товаре, комментарии к статье, вопросы и ответы | Динамическая подгрузка скрывает часть содержимого и ломает возврат | URL состояния, доступность, порядок элементов, модерация удаленного контента |
| Документация и база знаний | Статьи, методы API, термины, записи справочника | Пользователю нужна глубокая ссылка, а алфавитная сортировка может меняться | Стабильный порядок, поиск по разделу, ссылки на отдельные документы |
| Внутренний поиск | Результаты запроса | Почти бесконечное число комбинаций и часто низкая самостоятельная ценность | Нужна ли индексация вообще, откуда появляются ссылки на такие URL |
| Фильтры и сортировки | Срезы того же списка | Комбинаторный рост адресов и множество близких страниц | Какие комбинации являются посадочными, а какие нужны только интерфейсу |
В этой таблице намеренно нет колонки «индексировать» или «закрыть». До такого решения еще нужно определить, является ли URL обычной частью серии, отдельной полезной посадочной страницей, технической сортировкой или результатом внутреннего поиска.
Например, в каталоге вакансий вторая страница общего списка и страница «удаленная работа для дизайнеров» выполняют разные функции. Первая продолжает выдачу. Вторая может отвечать самостоятельному спросу. А сортировка тех же вакансий по дате или зарплате способна быть только пользовательским состоянием. Если назвать все три случая пагинацией, архитектура быстро превращается в набор исключений.
Окей, а что именно настраивать?
До разговора о Google и Яндексе полезно разложить инструменты по полкам. Иначе canonical начинают использовать как noindex, robots.txt — как способ удалить страницу из поиска, а Sitemap — как замену внутренним ссылкам.
| Механизм | Для чего нужен | Чего не делает | Типичная ошибка |
|---|---|---|---|
Внутренняя ссылка <a href> |
Помогает роботу и пользователю обнаружить URL и перейти по нему | Не гарантирует индексирование и показ в выдаче | Следующая порция доступна только после выполнения JavaScript |
robots.txt (откроется в новой вкладке) |
Ограничивает обход URL или группы URL | Не является надежным способом удалить уже известный адрес из поиска | Закрыть URL, но ожидать, что робот прочитает расположенный на нем noindex или новый canonical |
noindex (откроется в новой вкладке) |
Просит не включать полученную страницу в поиск | Не запрещает роботу запрашивать URL | Называть метатег способом «закрыть сканирование» |
rel="canonical" (откроется в новой вкладке) |
Подсказывает предпочтительный адрес для дублей и очень похожих страниц | Не запрещает обход и не является строгой командой исключить любой неудобный URL | Канонизировать различающиеся страницы серии на первую только потому, что у них общий шаблон |
| HTTP-код (откроется в новой вкладке) | Сообщает, существует ли ресурс и что с ним произошло | Код 200 не гарантирует индексирование | Возвращать 200 для любого номера, даже если элементов там нет и никогда не было |
Здесь особенно важно развести два понятия.
Доступность для обхода означает, что робот может найти и получить URL.
Возможность индексирования означает, что страницу разрешено рассматривать для включения в индекс. Даже если технических запретов нет, поисковая система не обязана индексировать адрес.
Отсюда первый практический вывод: «робот может пройти по страницам серии» и «каждый номер должен быть в индексе» — не одно и то же.
Второй вывод касается ответа сервера. Существующая страница, которая претендует на индексирование в Google, должна нормально открываться и возвращать 200 — но это все, о чем говорит код. Не пропуск в выдачу и не подтверждение выбранного canonical.
И третий вывод: canonical имеет смысл там, где действительно есть дубли или почти одинаковые URL. Общий шаблон сам по себе дублем не делает.
Что сейчас говорит Google
У Google сейчас довольно прямой базовый сценарий для пагинации и порционной загрузки — он собран в рекомендациях по пагинации и постепенной загрузке (откроется в новой вкладке).
- Каждая часть должна иметь собственный постоянный URL.
- Страницы серии нужно связывать обычными HTML-ссылками с
href. - Для обычной пагинированной серии каждая страница указывает canonical на себя, а не на первую страницу категории.
Условно это выглядит так:
На второй странице:
<link rel="canonical" href="/catalog/page/2/">А ссылка на третью страницу существует в исходном или отрендеренном HTML как ссылка:
<a href="/catalog/page/3/">3</a>Почему недостаточно одной кнопки? Googlebot не следует пользовательскому сценарию так, как это делает человек. В той же справке об этом сказано прямо: краулеры Google не «нажимают» кнопки (откроется в новой вкладке) и обычно не запускают JavaScript-функции, которым для обновления содержимого нужно действие пользователя. Если URL нигде не связан обычной ссылкой, надеяться только на интерактивный элемент рискованно.
Отдельный важный момент — canonical на первую страницу. Для последовательности с разными элементами Google прямо не рекомендует такую схему: «не используйте первую страницу серии как каноническую» (откроется в новой вкладке). Первая страница не содержит все товары, статьи или объявления со второй и третьей, а значит, это не обычные дубли.
Что с rel=next и rel=prev? Google больше не использует эти атрибуты (откроется в новой вкладке) как сигнал пагинации — об этом объявили в марте 2019 года, через восемь лет после того, как их сами же и ввели (откроется в новой вкладке). Их наличие не нужно включать в обязательное SEO-ТЗ для Google. При этом делать более широкий вывод «атрибуты бесполезны вообще для всех систем и задач» тоже не стоит.
Еще одна граница: рекомендация описывает обнаружение и устройство серии, а решение об индексировании поисковая система принимает отдельно.
И, наконец, фильтры и сортировки нельзя автоматически считать продолжением обычной пагинации. Адрес ?page=2 и адрес ?sort=price&color=red&page=2 принадлежат разным URL-классам. У второго сначала нужно решить судьбу фильтра и сортировки, а уже потом настраивать номера внутри этого среза. У Google для фасетов есть отдельное руководство (откроется в новой вкладке), и оно заметно строже: большинству сайтов там советуют ограничить обход таких URL через robots.txt. Применять это по умолчанию не стоит — сначала нужно понять, какие срезы реально работают как посадочные. Но знать об официальной рекомендации полезно, чтобы отклонение от нее было осознанным.
А что с Яндексом?
Здесь ответ менее удобный: одной свежей официальной страницы, где была бы полностью описана настройка пагинации, найти по-прежнему не получается. Информацию приходится собирать по частям из материалов о canonical, дублях, JavaScript и инструментах Вебмастера.
Это важно не только как замечание к справке. Из фрагментов нельзя честно собрать правило, которого в них нет, например: «Яндекс рекомендует всем сайтам ставить canonical со второй и последующих страниц на первую».
Что можно утверждать аккуратно?
Во-первых, canonical для Яндекса остается рекомендацией. В справке это сказано дословно: робот «воспринимает указание на канонический адрес как рекомендацию и может проигнорировать его» (откроется в новой вкладке) — в том числе когда содержимое неканонической страницы существенно отличается и лучше отвечает на запрос. Отдельно об этом был пост 2019 года (откроется в новой вкладке): неканонические страницы стали показывать в выдаче, если они релевантнее запросу. Показательно, что один из примеров в посте — как раз пагинация: ветка форума, где нужный ответ находится не на первой странице. Для нашей темы это существенная оговорка: разные наборы товаров, тем или статей нельзя объявить дублями только из-за одинаковой шапки и шаблона.
Во-вторых, Яндекс умеет исполнять JavaScript и получать появляющийся после рендеринга контент — этим даже можно управлять в Вебмастере (откроется в новой вкладке). Но сам факт такой поддержки не гарантирует, что робот увидит нужный блок при любой реализации. Результат нужно проверять по тому содержимому, которое фактически получил поиск. Серверный рендеринг или пререндеринг при этом остаются допустимыми способами передать тот же контент без зависимости от отдельного этапа исполнения JavaScript.
В-третьих, значительная часть подробных официальных публикаций на эту тему находится в архиве — например, материал об индексировании AJAX-сайтов (откроется в новой вкладке). Они полезны для понимания принципов, но названия разделов, состав отчетов и отдельные элементы интерфейса Вебмастера могли измениться. Поэтому в техническом задании лучше писать не «нажать конкретный пункт меню», а «проверить отрендеренное содержимое, HTTP-ответ, canonical и состояние выбранного URL».
Базовая схема, с которой имеет смысл начинать
Допустим, перед нами обычный список: категория товаров, архив статей, раздел форума или каталог специалистов. Фильтры, сортировки и внутренний поиск пока оставим за скобками. Как превратить общие рекомендации в техническую постановку?
1. Выберите один формат URL
Путь или параметр сами по себе не делают пагинацию лучше либо хуже:
example.ru/articles/page/2/example.ru/articles/?page=2Важно другое: формат должен быть постоянным и однозначным. Одна и та же вторая страница не должна одновременно открываться по /page/2/, ?page=2, ?p=2 и еще нескольким адресам без понятной нормализации. Для незначащих параметров вроде меток аналитики у Яндекса есть директива Clean-param (откроется в новой вкладке), но она решает частную задачу и не заменяет единый формат самих номеров.
Отдельно договоритесь о первой странице. Обычно основным адресом остается URL раздела без page=1, например example.ru/articles/. Если вариант с ?page=1 технически существует, он не должен конкурировать с основным адресом. Можно настроить перенаправление или последовательную каноникализацию, но выбранное правило должно совпадать во внутренних ссылках.
2. Сделайте порядок элементов предсказуемым
Пагинация режет не абстрактный набор, а отсортированную последовательность. Если порядок меняется при каждом запросе, один товар или документ может гулять между страницами, а другой — временно исчезать из последовательного обхода.
Для каталога это может быть сортировка по заданному бизнес-правилу, для архива — по дате и дополнительному стабильному признаку, для справочника — по алфавиту и идентификатору. Важен не конкретный вариант, а воспроизводимость. При одинаковых условиях сервер должен собирать страницы серии одинаково.
Новые элементы все равно будут сдвигать старые. Это нормально для новостей, вакансий и объявлений. Задача не в том, чтобы навсегда заморозить каждый номер, а в том, чтобы избежать случайного перемешивания внутри одного и того же состояния списка.
3. Свяжите страницы обычными ссылками
Минимум, который нужен серии, — последовательный путь вперед. На первой странице есть ссылка на вторую, на второй — на третью и так далее. Для человека обычно полезны также ссылка назад, переход к первой странице и несколько соседних номеров.
Необязательно выводить сотни ссылок на все номера сразу. Важно, чтобы до глубокой страницы существовал последовательный путь по a href, а не только команда JavaScript.
<nav aria-label="Страницы каталога"> <a href="/catalog/page/2/">2</a> <a href="/catalog/page/3/">3</a> <a href="/catalog/page/2/" rel="next">Следующая</a></nav>rel="next" в этом примере не является SEO-требованием Google. Значение имеет сам href. Если атрибут используется в проекте для других задач, его не нужно срочно удалять; просто не стоит считать его заменой ссылочной навигации.4. Согласуйте canonical, ссылки и Sitemap
Для обычной серии с разными элементами базовый вариант — self-canonical:
- у первой страницы canonical ведет на основной URL раздела;
- у второй — на URL второй;
- у третьей — на URL третьей.
Внутренние ссылки при этом ведут на те же выбранные адреса. Если индексируемые страницы серии добавляются в Sitemap, там также должны быть канонические URL, а не их альтернативы.
Sitemap полезен как дополнительный источник обнаружения, но не заменяет внутренние ссылки. Google формулирует это прямо (откроется в новой вкладке): карта сайта помогает найти URL, но не гарантирует, что все перечисленные адреса будут обойдены и проиндексированы. Если до товара, статьи или профиля нельзя дойти по навигации сайта, строка в Sitemap не исправляет саму архитектуру.
5. Определите последнюю страницу и крайние случаи
Существующая страница возвращает 200 и содержит ожидаемую порцию элементов. Несуществующий номер, например /page/999/ при десяти страницах в разделе, не должен отдавать пустой шаблон с кодом 200. Для действительно отсутствующего адреса подходит 404, а для намеренно и окончательно удаленного ресурса возможен 410.
Разницу между этими двумя кодами не стоит переоценивать: Google обрабатывает все ответы 4xx одинаково (откроется в новой вкладке), и 410 не ускоряет удаление адреса из индекса. Выбор между ними — вопрос честной семантики ресурса и вашей собственной диагностики, а не отдельного сигнала для поиска. Принципиально другое: не отдавать 200 там, где ресурса нет.
Не стоит автоматически перенаправлять любой лишний номер на первую или последнюю страницу. Такой редирект маскирует ошибочный URL и мешает отличить существующее состояние от несуществующего.
С пустыми выдачами нужна оговорка. Результат фильтра «товаров пока нет» может быть реальным пользовательским состоянием, а /page/25/ после сокращения списка — уже несуществующим номером. Это разные случаи, и HTTP-ответ следует выбирать по смыслу ресурса, а не по одному признаку «на экране нет карточек».
Здесь стоит отметить расхождение с буквой справки: в руководстве по фасетной навигации Google советует отдавать 404, когда комбинация фильтров не дала результатов. Совет разумен против бесконечной генерации пустых комбинаций, но механически распространять его на любой пустой список не нужно. Категория, которая временно распродана, и заведомо бессмысленное пересечение фильтров — это не одно и то же.
6. Продумайте изменение размера списка
Если в категории было 25 страниц, а после удаления объектов осталось 20, адреса с 21-й по 25-ю перестают представлять свои прежние блоки. Тут возможны разные продуктовые решения, но нельзя бесконечно оставлять пустые страницы с 200.
Похожая ситуация возникает при смене количества элементов на странице. Переход с 20 карточек на 48 полностью меняет границы серии. Такие изменения лучше считать миграцией URL-структуры: проверить старые адреса, ссылки, canonical, карту сайта и логи, а не просто поменять число в шаблоне.
Что делать с кнопкой «Показать ещё» и бесконечной лентой
С обычной нумерацией понятно. Но что, если дизайнер и продукт хотят оставить кнопку или бесконечную ленту? Оставлять можно.
Удобный JavaScript-интерфейс не противоречит SEO, если он работает поверх понятной URL-серии, а не вместо нее.
Практическая схема выглядит так.
- У каждой порции контента есть отдельный URL.
- До следующего URL можно добраться по обычной ссылке, даже если в основном интерфейсе она оформлена как кнопка или скрыта прогрессивным улучшением.
- При подгрузке сайт корректно обновляет состояние браузера, чтобы адрес можно было скопировать, открыть в новой вкладке и восстановить после возврата назад.
- Прямой вход на глубокий URL сразу показывает соответствующую часть списка, а не всегда переносит человека на начало.
- Если JavaScript не выполнился, основная навигация и контент не исчезают полностью.
Для истории браузера можно использовать History API (откроется в новой вкладке). Конкретный выбор между pushState и replaceState зависит от сценария: нужно ли каждое состояние проходить кнопкой «Назад» или достаточно сохранять текущую позицию. Важно проверить итоговое поведение, а не просто увидеть меняющийся адрес в строке браузера.
Проверка глазами пользователя
Представим каталог из десяти страниц. Человек открыл первую, дважды нажал «Показать ещё», перешел в карточку, а затем вернулся назад.
Хороший результат: он видит тот же набор и примерно ту же позицию прокрутки, адрес отражает открытое состояние, повторная загрузка URL восстанавливает нужную часть списка.
Плохой результат: браузер возвращает на начало первой страницы, уже загруженные элементы исчезают, а скопированный URL не воспроизводит состояние.
Доступность тоже относится к качеству реализации
Бесконечная лента создает дополнительные задачи для людей, которые используют клавиатуру или вспомогательные технологии. Динамический блок должен сообщать о состоянии загрузки, а перемещение между элементами должно оставаться управляемым. У W3C для этого есть готовый разбор — паттерн feed (откроется в новой вкладке), где расписано, как связать фокус в DOM с подгрузкой следующей порции.
Проверьте как минимум следующее:
- кнопка доступна с клавиатуры и имеет понятное название;
- после подгрузки фокус не прыгает в неожиданное место;
- состояние загрузки сообщается, а повторное нажатие не запускает хаотично несколько запросов;
- пользователь может добраться до элементов после добавленного блока и, если это нужно интерфейсу, до футера;
- переход назад и прямое открытие URL работают;
- интерфейс протестирован с реальными вспомогательными технологиями, а не только по наличию ARIA-атрибутов.
Семантический HTML остается основой — первое правило использования ARIA (откроется в новой вкладке) о том же: если подходящий нативный элемент существует, берите его. ARIA помогает описать сложное динамическое поведение, но не исправляет отсутствующие ссылки, неправильный порядок фокуса или недоступную кнопку.
Обе системы обрабатывают отрендеренный контент, но строить навигацию в расчете на гарантированное выполнение скрипта не стоит. Надежнее сначала обеспечить адреса и ссылки, а подгрузку добавить поверх.
Нужно ли уникализировать тексты и метатеги
В старой схеме встречался понятный прием: добавить «страница 2» в title, description, H1 и хлебные крошки, убрать часть коммерческих формулировок и тем самым сильнее отличить пагинацию от основной категории.
Сегодня этот прием нельзя выдавать за обязательное требование Google. Для распознанной серии одинаковые title и description допустимы. Поисковая система не обещает индексировать URL только потому, что в метатег добавили номер.
Значит ли это, что ничего менять не нужно? Тоже нет. Здесь полезнее исходить из задачи конкретного элемента.
| Элемент | Базовый вариант | Когда имеет смысл менять |
|---|---|---|
title |
Сохранить понятное название раздела | Добавить номер, если он помогает отличить страницы в браузере, диагностике или сниппете |
description |
Допустим общий шаблон без искусственных вариаций | Уточнить номер или диапазон, если описание остается полезным и не превращается в набор перестановок слов |
H1 |
Оставить название категории или архива | Добавить номер, если человеку важно понимать, где он находится |
| Хлебные крошки | Показать путь до раздела | Добавить текущую страницу, если это соответствует навигации и не перегружает цепочку |
| Вводный SEO-текст | Чаще оставить на первой странице | Повторять дальше только при реальной пользовательской пользе, а не для заполнения шаблона |
| Преимущества, доставка, карта, отзывы | Решать по функции блока | Не дублировать автоматически на каждом номере, если блок не помогает работать со списком |
Пример спокойного варианта:
<!-- первая страница -->Холодильники в Москве — каталог и цены<!-- вторая страница -->Холодильники в Москве — страница 2Это нормальная редакционная настройка. Но из нее не следует, что вторая страница обязательно попадет в индекс, а первая гарантированно станет релевантной по всем запросам категории.
Отдельно стоит отказаться от механической «деоптимизации». Урезать title на страницах 2, 3 и далее только ради того, чтобы поисковик предпочел первую, — слишком грубая модель. Релевантность зависит не от одного метатега, а canonical не становится строже после удаления пары слов.
И точно не нужно превращать номера пагинации в посадочные страницы под разные запросы. «Красные холодильники», «холодильники с верхней морозилкой» и «холодильники в Химках» требуют осмысленной архитектуры категорий, фильтров или геостраниц. Вторая и третья страницы общей категории для этой роли не предназначены.
Как делать точно не нужно
Большая часть проблем появляется не из-за одного неправильного тега. Чаще сайт отправляет поиску несколько сигналов, которые противоречат друг другу.
| Что сделали | В чем конфликт | Что проверять или менять |
|---|---|---|
Закрыли URL в robots.txt и одновременно поставили на нем noindex |
Робот может не получить страницу и не прочитать актуальную директиву | Сначала определить цель: ограничить обход или исключить доступную страницу из поиска |
| Закрыли обход и ждут, что робот учтет новый canonical | Canonical расположен на странице, которую робот не может нормально запросить | Устранить конфликт и обеспечить доступ к сигналу, если он должен быть прочитан |
| Указали первую страницу canonical для всей серии | Вторая и последующие страницы содержат другие элементы и не являются обычными дублями первой | Для обычной серии использовать самостоятельные URL и self-canonical; объединять только настоящие дубли |
| Оставили только «Показать ещё» без URL и ссылок | Следующий блок существует лишь после пользовательского действия | Создать адреса порций и связать их через a href |
| Любой номер возвращает пустой шаблон с 200 | Несуществующий ресурс выглядит для робота как существующая страница | Определять реальную последнюю страницу и отдавать 404/410 для отсутствующего номера |
Добавили rel=next/prev и на этом закончили |
Google не использует эти атрибуты как сигнал пагинации, а URL могут остаться несвязанными | Проверить обычные ссылки, canonical и ответы сервера |
| Разрешили индексирование всех фильтров и сортировок | Число комбинаций быстро растет, многие адреса показывают близкие наборы | Сначала классифицировать параметры и выбрать полезные посадочные срезы |
| Оптимизировали страницу 2 под один запрос, страницу 3 под другой | Номер описывает позицию в серии, а не устойчивый поисковый интент | Создать отдельную категорию, тег, фильтр или другую подходящую посадочную архитектуру |
| Сделали из номеров геостраницы | Смена города не связана с порядком элементов в одной серии | Проектировать географическую структуру отдельно и выбирать ее по устройству бизнеса и сайта |
Есть еще один тихий анти-паттерн: менять сразу все. Команда одновременно переводит параметры в путь, включает JS-подгрузку, меняет размер страницы, открывает URL для индексирования и перестраивает canonical. После релиза становится трудно понять, какая правка вызвала конкретный эффект или ошибку.
Если проект крупный, безопаснее сначала описать ожидаемое состояние каждого класса URL, внедрить изменения на ограниченном разделе, проверить логи и панели поисковых систем, а затем расширять схему.
Что в итоге делать на конкретном сайте
Универсального ответа «все индексировать» или «все закрыть» нет. Зато есть последовательность, которая заметно сокращает количество случайных решений.
Шаг 1. Проведите инвентаризацию URL-классов
Не начинайте с директив. Сначала выпишите, какие адреса создает листинг:
- обычные номера страниц;
- сортировки;
- фильтры и фасеты;
- комбинации фильтров;
- результаты внутреннего поиска;
- служебные параметры аналитики;
- варианты количества элементов на странице;
- печатные, мобильные и другие альтернативные представления, если они есть.
У каждого класса должна быть своя политика. Запись «закрыть пагинацию» слишком грубая, если под нее случайно попадают полезные категории, фильтры и технический мусор одновременно.
Шаг 2. Ответьте, имеет ли URL самостоятельную ценность
Полезно задать несколько вопросов.
- Содержит ли страница другой набор конечных элементов?
- Может ли человек осмысленно открыть или сохранить этот адрес?
- Есть ли у среза устойчивый спрос или отдельная навигационная задача?
- Не дублирует ли URL тот же контент из-за порядка параметров или метки аналитики?
- Нужен ли адрес поиску как самостоятельная посадочная либо только интерфейсу?
Обычная вторая страница категории часто является реальной частью списка, но это еще не означает обязательного присутствия в индексе. Фильтр «красные холодильники» может быть отдельной посадочной, если он спроектирован как таковая. Сортировка тех же товаров по цене обычно решает пользовательскую задачу, но не обязательно создает новую поисковую страницу.
Шаг 3. Сначала обеспечьте обнаружение конечных материалов
Независимо от решения об индексировании номеров товары, статьи, темы, объявления и профили не должны становиться сиротами.
Проверьте, есть ли до них путь через:
- страницы серии;
- рубрики и подрубрики;
- связанные материалы;
- карты разделов и другие реальные элементы навигации;
- Sitemap как дополнительный, но не единственный канал.
Если глубокая карточка доступна только после нескольких нажатий на кнопку, а отдельного URL и ссылочного пути нет, сначала исправляется обнаружение. Только затем имеет смысл спорить о noindex.
Шаг 4. Выберите политику индексирования
Решение можно зафиксировать в матрице.
| Сценарий | Базовое направление | Что меняет решение |
|---|---|---|
| Товарная категория с разными товарами на каждом номере | Доступная серия с постоянными URL и self-canonical | Очень короткий список, альтернативная навигация ко всем товарам, ограничения обхода и качество глубоких страниц |
| Маркетплейс или объявления с быстро меняющимся составом | Та же базовая серия плюс особое внимание к стабильной сортировке и удаленным объектам | Срок жизни карточек, частота обновления, число параметрических комбинаций |
| Новостной или статейный архив | Доступная последовательность и надежные ссылки на старые материалы | Наличие архивов по датам, рубрикам и авторам, которые уже решают обнаружение |
| Форум или комментарии | Постоянные адреса страниц и, при необходимости, якоря отдельных сообщений | Порядок показа новых ответов, модерация, глубокие ссылки |
| Каталог специалистов или услуг | Отдельно решить пагинацию и полезные географические либо тематические срезы | Реальный спрос, уникальность среза, качество профилей |
| Документация или справочник | Стабильный порядок и глубокие ссылки на документы | Возможность заменить длинный список иерархией, алфавитом или поиском без потери обнаружения |
| Сортировка | Чаще пользовательское состояние, а не новая посадочная | Если конкретный порядок сам по себе выполняет устойчивую отдельную задачу |
| Внутренний поиск | Обычно не кандидат на массовое индексирование | Редкие специально спроектированные страницы спроса, которые уже ближе к категориям, чем к поисковой выдаче |
Это не таблица с вечными директивами. Она показывает, какие свойства нужно проверить до внедрения.
Шаг 5. Подберите интерфейс после URL-архитектуры
Когда классы адресов и их политика определены, можно выбирать нумерацию, кнопку или бесконечную ленту. Тогда дизайн не диктует SEO-логику, а использует уже понятную модель состояний.
Для каталога с возвращением к сравнению часто удобна нумерация или гибрид «Показать ещё» с доступными номерами. Для новостной ленты подойдет бесконечная подгрузка, если сохраняются URL, история и доступность. Для документации иногда лучше вообще не умножать страницы, а улучшить иерархию и навигацию по буквам.
Шаг 6. Запишите ожидаемый результат до релиза
Для каждого типа URL заранее укажите:
- ожидаемый HTTP-код;
- доступность обхода;
- наличие или отсутствие noindex;
- canonical;
- наличие в Sitemap;
- откуда приходит внутренняя ссылка;
- что должен увидеть пользователь при прямом открытии;
- что должно произойти после нажатия «Назад».
Так настройка перестает быть набором тегов и превращается в проверяемую спецификацию.
Как проверить внедрение после релиза
Самая аккуратная схема на бумаге может сломаться в шаблоне, JavaScript, CDN или серверной логике. Поэтому приемка нужна не только перед выкладкой, но и на реальном окружении.
Соберите фиксированную выборку
Не проверяйте одну вторую страницу и не делайте вывод обо всем разделе. Возьмите как минимум разные роли URL:
- Основная страница списка.
- Вторая страница.
- Глубокая страница.
- Последняя существующая страница.
- Следующий несуществующий номер.
- Популярный фильтр.
- Бесполезная комбинация фильтров.
- Сортировка.
- Страница с динамической подгрузкой.
- Несколько конечных карточек с разной глубиной.
Для быстро меняющихся сайтов добавьте URL удаленного объявления, старой новости или закрытой вакансии. Для форума — ссылку на глубокое сообщение. Для базы знаний — документ, который находится далеко от первой страницы справочника.
Пройдите сайт краулером
Сначала полезно сравнить два режима: без выполнения JavaScript и с рендерингом. Это покажет, существуют ли ссылки в базовом HTML, появляется ли контент только после скрипта и одинаково ли определяется canonical. Если расхождение нашлось, дальше помогает чек-лист Google по JavaScript-проблемам в поиске (откроется в новой вкладке).
Проверьте:
- какие URL обнаружены;
- сколько кликов отделяет глубокие материалы от доступной точки входа;
- нет ли циклов, ловушек параметров и бесконечной генерации номеров;
- совпадают ли canonical с адресами внутренних ссылок;
- где стоят noindex и запреты robots.txt;
- какие коды возвращают существующие и несуществующие страницы;
- не создают ли фильтры и сортировки неожиданно большой набор адресов.
Посмотрите серверные логи
Краулер показывает, как сайт может обходиться. Логи показывают, как к нему реально обращаются роботы.
Полезно сравнить частоту запросов к первой, второй и глубоким страницам, увидеть обращения к лишним параметрам, повторяющиеся ошибки и длинные цепочки редиректов. Если робот активно обходит тысячи сортировок, а до важных глубоких карточек почти не доходит, проблема уже не выглядит теоретической. Именно это Google и описывает как расход краулингового бюджета (откроется в новой вкладке): обход тратится на уникальные адреса вместо уникального контента. На небольшом сайте вопрос обычно не стоит, на крупном каталоге становится основным.
Проверьте Google Search Console
Отчет об индексировании страниц (откроется в новой вкладке) помогает увидеть групповые причины — для пагинации чаще всего всплывают статусы «Страница является копией, canonical не выбран пользователем» и «Страница просканирована, но пока не проиндексирована». Состояние же конкретного адреса лучше проверять через инструмент проверки URL (откроется в новой вкладке).
Для URL из выборки сопоставьте:
- проиндексированную версию и опубликованную версию;
- возможность получить страницу;
- выбранный Google canonical;
- содержание отрендеренной страницы;
- сведения о Sitemap и ссылках, если они доступны;
- причину, по которой URL не индексируется или считается альтернативным.
Положительная проверка опубликованной версии означает, что страницу можно получить и обработать в рамках теста. Она не гарантирует включение в индекс. Ровно так же отсутствие отдельного примера в групповом отчете не всегда означает, что Google ничего не знает об URL.
Проверьте Яндекс Вебмастер
Для Яндекса смотрите фактические данные по страницам и группам URL: даты обхода, HTTP-ответы, canonical, присутствие в Sitemap и доступное состояние адреса. Отдельные адреса удобно прогонять через проверку ответа сервера (откроется в новой вкладке), а для массовой сверки есть расширенная статистика по сайту (откроется в новой вкладке) — выгрузка с URL, кодом последнего обхода, датой и указанным canonical. На большом сайте, где вручную открыть все номера нельзя, это и есть основной рабочий инструмент.
Названия разделов и набор полей со временем меняются, поэтому привязывать регламент к одному пункту меню не стоит. Регламент должен отвечать на вопросы: когда робот был на странице, что получил, какой код увидел, какой canonical указан и участвует ли URL в нужном поисковом сценарии.
Отдельно пройдите пользовательский сценарий
Технические панели не покажут все проблемы кнопки «Назад», фокуса и бесконечной ленты. Откройте глубокий URL напрямую, подгрузите несколько порций, перейдите в карточку, вернитесь, обновите страницу, скопируйте адрес в другую вкладку. Затем повторите путь с клавиатуры и, если динамическая лента важна продукту, со вспомогательной технологией.
Результаты удобно фиксировать в простой таблице:
| URL или сценарий | Что ожидаем | Что получили | Статус | Что исправить |
|---|---|---|---|---|
| Страница 2 | 200, self-canonical, ссылка с первой | |||
| Последняя страница | 200, элементы списка, ссылка назад | |||
| Несуществующий номер | 404 или 410 | |||
| Сортировка | Политика по матрице URL-классов | |||
| «Показать ещё» | URL, история, восстановление состояния |
Такая приемка полезнее общей цифры «проиндексировано N страниц». Она позволяет вернуться к тем же адресам после изменения шаблона и понять, что именно поменялось.
Когда повторять проверку? После изменения размера страницы, сортировки по умолчанию, структуры URL, canonical, правил robots.txt, JavaScript-подгрузки, шаблона фильтров и логики удаления объектов. На сайтах с быстро меняющимся контентом часть выборки стоит отслеживать регулярно.
И помните: в SEO по-прежнему мало абсолютных решений. Схема, которая подходит большому маркетплейсу, может быть избыточной для небольшого справочника, а решение новостной ленты — неудобным для каталога специалистов. Но это не значит, что остается действовать наугад. Разделите интерфейс и URL, классифицируйте страницы, не смешивайте инструменты и проверяйте результат на данных. Тогда пагинация перестает быть вопросом веры и становится обычной технической задачей.
Частые вопросы
Спрашивают чаще всегоНужно ли ставить canonical со второй страницы на первую
Для обычной серии с разными элементами — нет: Google прямо не рекомендует такую схему, потому что первая страница не содержит товары, статьи и объявления со второй и третьей. Базовый вариант — self-canonical на каждой странице серии.
Работают ли rel="next" и rel="prev"
Google больше не использует эти атрибуты как сигнал пагинации, поэтому в обязательное ТЗ их включать не нужно. Если они уже стоят и используются для других задач — срочно удалять не обязательно, но заменой обычных ссылок они не являются.
Можно ли оставить «Показать ещё» и бесконечную ленту
Можно, если интерфейс работает поверх URL-серии, а не вместо нее: у каждой порции есть постоянный адрес, до следующего ведет обычная ссылка, а прямое открытие глубокого URL и возврат назад восстанавливают нужную часть списка.
Что отдавать на несуществующем номере страницы
Для действительно отсутствующего адреса — 404, для намеренно и окончательно удаленного ресурса — 410. Пустой шаблон с кодом 200 и автоматический редирект на первую страницу маскируют ошибочный URL.
Что рекомендует Яндекс
Отдельной свежей инструкции по пагинации найти не получается, поэтому правило «ставить canonical на первую страницу» из фрагментов справки не собирается. Аккуратный вывод: canonical остается рекомендацией, JavaScript исполняется, но результат нужно проверять по фактически полученному роботом содержимому.
SEO-специалист с 2017 года. Крупные каталоги и сайты услуг: аудит, семантика, структура. Сейчас беру консультации.
Написать ❱